Entgegen der Annahme, dass schnelle Entscheidungen Zeit sparen, führt das vorzeitige Beenden von A/B-Tests direkt in die Gewissheitsfalle und kostet Sie langfristig Umsatz.
- Ein Konfidenzniveau von 95 % ist keine Empfehlung, sondern eine mathematische Notwendigkeit, um « Daten-Halluzinationen » (Zufallsergebnisse) zu vermeiden.
- Tests ohne negatives Ergebnis sind keine Fehlschläge, sondern wertvolle Bausteine in Ihrem Lern-Portfolio, die falsche Hypothesen widerlegen.
Empfehlung: Etablieren Sie eine Kultur der statistischen Disziplin. Betrachten Sie die korrekte Testdauer nicht als Bremse, sondern als die einzige Beschleunigungsmethode für valide, profitable Entscheidungen.
Als ambitionierter CRO-Manager leben Sie in einem ständigen Spannungsfeld: Der Druck, schnelle Ergebnisse zu liefern, ist enorm. Sie sehen eine Variante im A/B-Test nach zwei Tagen mit 30 % Uplift vorne und die Versuchung ist fast unwiderstehlich, den Test zu beenden, den « Gewinner » auszurollen und den Erfolg zu verbuchen. Die gängigen Ratschläge – « Warte auf statistische Signifikanz » oder « Lass den Test zwei Wochen laufen » – klingen in Ihren Ohren wie eine unnötige Verzögerung. Sie brauchen Geschwindigkeit. Sie brauchen Resultate. Jetzt.
Doch genau hier lauert die grösste und teuerste Falle in der Conversion-Rate-Optimierung. Dieses « Peeking », das vorzeitige Beenden von Tests, ist keine Abkürzung zum Erfolg, sondern eine garantierte Investition in falsche Daten. Sie agieren auf der Basis von statistischem Rauschen und feiern möglicherweise eine Variante, die in Wahrheit schlechter performt als das Original. Das ist keine Optimierung, das ist ein Glücksspiel mit dem Umsatz Ihres Unternehmens. Die wahre Herausforderung ist nicht, schnell zu sein, sondern schnell *richtig* zu liegen.
Was wäre, wenn die eigentliche Geschwindigkeit nicht von kurzen Testlaufzeiten, sondern von unerbittlicher wissenschaftlicher Disziplin herrührt? Dieser Artikel ist Ihr Coaching, um genau diesen Paradigmenwechsel zu vollziehen. Wir werden nicht nur die Grundlagen der statistischen Signifikanz wiederholen. Wir werden die psychologischen Fallen aufdecken, die Sie zu voreiligen Schlüssen verleiten, und Ihnen Frameworks an die Hand geben, um Ihre Test-Hypothesen rigoros zu priorisieren. Sie lernen, wie Sie externe Störfaktoren eliminieren, komplexe multivariate Tests strategisch einsetzen und, vielleicht am wichtigsten, wie Sie einen Test ohne Uplift nicht als Scheitern, sondern als entscheidenden Wissensgewinn feiern. Ziel ist es, Ihre Ungeduld in eine Stärke zu verwandeln: den unbedingten Willen, nur Entscheidungen auf der Grundlage unangreifbarer Daten zu treffen.
Dieser Leitfaden führt Sie durch die entscheidenden Aspekte der professionellen Testauswertung. Erfahren Sie, wie Sie methodische Strenge zur Grundlage Ihrer Optimierungsstrategie machen und so nachhaltiges Wachstum sichern.
Sommaire: Der Weg zur validen Testauswertung in der CRO
- Was bedeutet « 95% Konfidenz » und warum dürfen Sie vorher nicht entscheiden?
- Button-Farbe oder neues Layout: Was bringt Ihnen wirklich den Uplift?
- Wie verhindern Sie, dass Marketing-Kampagnen während des Tests Ihre Ergebnisse verfälschen?
- Einfach oder Komplex: Wann lohnt sich der Aufwand, 5 Variablen gleichzeitig zu testen?
- Wie feiern Sie einen Test, der keine Verbesserung brachte, als wichtigen Lernschritt?
- Wie identifizieren Sie frustrierte Nutzer, die wütend auf nicht funktionierende Elemente klicken?
- Wie finden Sie heraus, ob « Jetzt kaufen » oder « In den Warenkorb » besser funktioniert?
- Wie steigern Sie die Transaktionsrate von 1% auf 2% und verdoppeln damit effektiv den Gewinn?
Was bedeutet « 95% Konfidenz » und warum dürfen Sie vorher nicht entscheiden?
Das Konzept der statistischen Signifikanz ist das Fundament jeder validen A/B-Test-Auswertung. Ein Konfidenzniveau von 95 % bedeutet nicht, dass die Variante zu 95 % besser ist. Es bedeutet, dass eine 95-prozentige Sicherheit besteht, dass der beobachtete Unterschied zwischen Variante und Kontrolle kein reiner Zufall ist. Umgekehrt ausgedrückt: Es besteht immer noch eine Restwahrscheinlichkeit von 5 %, dass Sie einen Gewinner ausrufen, obwohl es in Wahrheit keinen Unterschied gibt – ein sogenannter falsch-positiver Fehler (Typ-I-Fehler). Dies ist keine theoretische Spitzfindigkeit, sondern eine harte Geschäftsrealität. Die Adobe Target Dokumentation zeigt, dass eine 5%ige Chance auf falsch-positive Ergebnisse bei diesem Konfidenzniveau die akzeptierte Norm in der Industrie ist.
Das vorzeitige Beenden eines Tests, nur weil eine Variante temporär vorne liegt, ist der häufigste und schwerwiegendste Fehler. Frühe Ergebnisse unterliegen starken Schwankungen (statistisches Rauschen). Ein anfänglicher « Gewinner » kann sich durch das Phänomen der Regression zur Mitte im weiteren Verlauf als Verlierer entpuppen. Ihre Entscheidung, den Test zu stoppen, basiert dann auf einer « Daten-Halluzination ». Sie tappen in die Gewissheitsfalle: Der Wunsch nach einer schnellen, klaren Antwort verleitet Sie dazu, zufällige Muster als signifikante Ergebnisse zu interpretieren.
Die einzige Methode, diese Falle zu umgehen, ist statistische Disziplin. Definieren Sie vor dem Teststart die benötigte Stichprobengrösse (Sample Size) basierend auf Ihrer Baseline-Conversion-Rate, dem erwarteten Uplift und der gewünschten statistischen Power (meist 80 %). Der Test läuft so lange, bis diese Stichprobengrösse erreicht ist – unabhängig davon, ob es einen Tag oder vier Wochen dauert. Nur so können Sie sicherstellen, dass Ihre Entscheidung auf einem stabilen Fundament und nicht auf dem Zufall basiert.
Button-Farbe oder neues Layout: Was bringt Ihnen wirklich den Uplift?
Die Versuchung ist gross, sich auf kleine, schnell umsetzbare Tests wie die Änderung einer Button-Farbe zu stürzen. Diese liefern zwar oft schnelle Ergebnisse, führen aber meist nur zu einer lokalen Optimierung – Sie erklimmen einen kleinen Hügel, während der riesige Berg unberührt bleibt. Echter, signifikanter Uplift entsteht oft durch mutigere, umfassendere Änderungen, die auf soliden Hypothesen basieren. Doch wie entscheiden Sie, welche Testidee das grösste Potenzial hat? Hier kommen Priorisierungs-Frameworks ins Spiel.
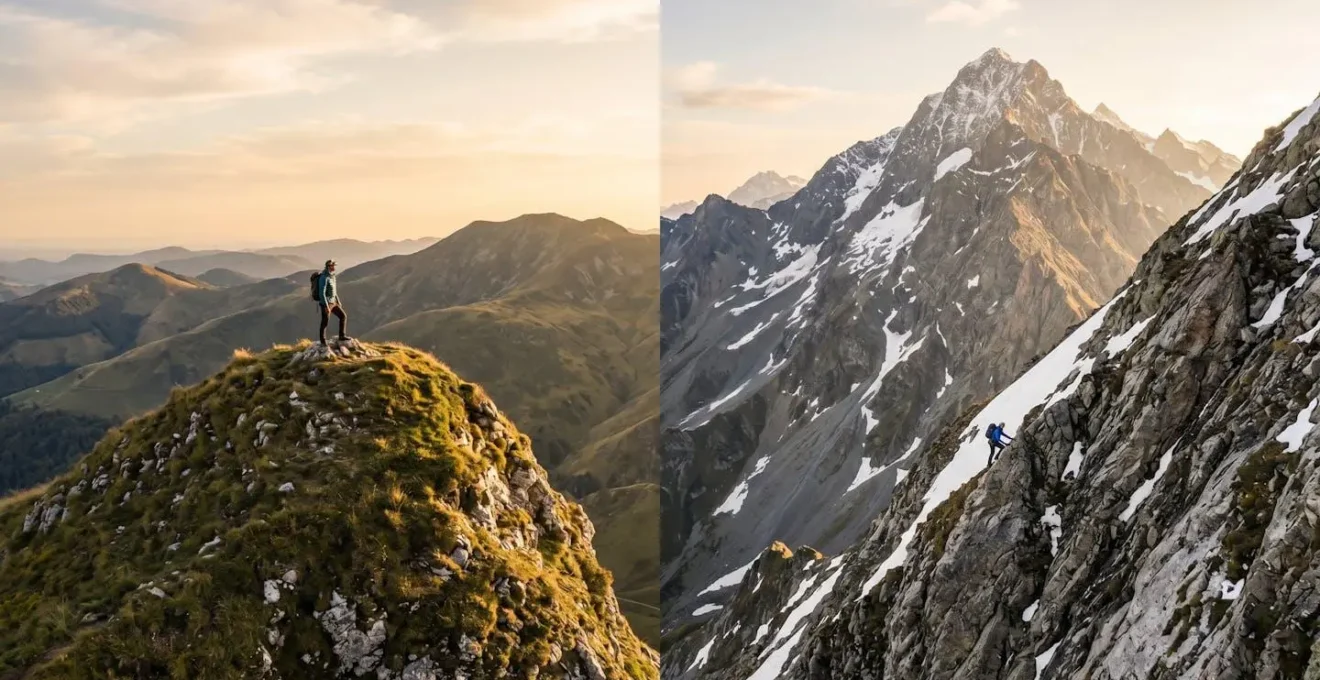
Wie die obige Metapher illustriert, ist der Aufwand, einen hohen Gipfel (globales Optimum) zu erreichen, grösser, aber die Belohnung ist unvergleichlich wertvoller als das Erklimmen eines kleinen Hügels (lokales Optimum). Ihre Aufgabe als CRO-Manager ist es, die Tests zu identifizieren, die Sie dem höchsten Gipfel näherbringen. Anstatt blind zu testen, bewerten Sie jede Hypothese systematisch. Das PIE-Framework (Potential, Importance, Ease) ist hier ein klassischer Ansatz. Sie bewerten auf einer Skala, wie viel Potenzial eine Änderung hat, wie wichtig die betroffene Seite (z.B. Warenkorb vs. « Über uns ») ist und wie einfach die Umsetzung ist.
Diese strukturierte Vorgehensweise zwingt Sie, über den Tellerrand hinauszuschauen und datengestützte Entscheidungen zu treffen, anstatt sich von Meinungen leiten zu lassen. Eine Studie von WiderFunnel, den Entwicklern des PIE-Frameworks, zeigte, dass Kunden, die solche Modelle nutzten, eine um über 50 % schnellere Time-to-Value für gewinnbringende Tests erzielten. Sie verschwenden weniger Zeit mit Tests mit geringem Potenzial und konzentrieren Ihre Ressourcen auf die wahren Hebel.
Um die richtige Methode für Ihr Team zu finden, hilft ein Vergleich der gängigsten Frameworks. Wie eine analyse vergleichender Frameworks bei CXL aufzeigt, hat jedes Modell seine eigenen Stärken.
| Framework | Kriterien | Bewertungsskala | Beste Anwendung |
|---|---|---|---|
| PIE | Potential, Importance, Ease | 1-10 pro Kriterium | Cross-funktionale Teams mit hohem Testvolumen |
| ICE | Impact, Confidence, Ease | 1-10 pro Kriterium | Agile Marketing-Teams mit wöchentlichen Tests |
| PXL | Objektive binäre Kriterien | 0-1 oder 0-2 | Datengetriebene Teams, die Subjektivität minimieren wollen |
Wie verhindern Sie, dass Marketing-Kampagnen während des Tests Ihre Ergebnisse verfälschen?
Ein A/B-Test ist ein wissenschaftliches Experiment. Seine wichtigste Voraussetzung ist eine kontrollierte Umgebung. Jede externe Variable, die nicht für beide Testgruppen (Kontrolle und Variante) gleichermassen gilt, verfälscht Ihre Ergebnisse und macht sie unbrauchbar. Die grösste Bedrohung für diese kontrollierte Umgebung sind oft unkoordinierte Marketing-Kampagnen. Stellen Sie sich vor, Sie testen zwei verschiedene Checkout-Prozesse, und mitten im Test schaltet das Marketing eine grosse Social-Media-Kampagne, die eine völlig neue, preissensible Zielgruppe auf die Seite spült. Das Verhalten dieser neuen Nutzer ist nicht mit dem der bisherigen Besucher vergleichbar, und Ihr Testergebnis wird wertlos.
Die einzige Lösung ist eine radikale Synchronisation und Transparenz zwischen dem CRO-Team und allen anderen Marketing-Abteilungen. Ein zentraler CRO-Marketing-Kalender ist hierfür unerlässlich. Darin müssen alle geplanten Aktionen – von E-Mail-Kampagnen über Rabattaktionen und TV-Spots bis hin zu Produkteinführungen – dokumentiert werden. Ihre Test-Roadmap muss kontinuierlich mit diesem Kalender abgeglichen werden, um Kollisionen zu vermeiden. Definieren Sie klare Kommunikationswege und Eskalationsprotokolle: Was passiert, wenn eine unerwartete, wichtige Kampagne live gehen muss? Der Test muss dann möglicherweise pausiert oder invalidiert werden. Das ist keine Niederlage, sondern eine notwendige Massnahme zur Wahrung der Datenintegrität.
Ein weiterer Aspekt der methodischen Sauberkeit ist die korrekte Interpretation. Wie das Adobe Target Team in seinen Best Practices warnt, ist die Versuchung gross, bei mehreren Varianten einfach die mit dem höchsten Uplift zum Sieger zu erklären, auch wenn der Unterschied zum Zweitplatzierten statistisch nicht signifikant ist. In den Worten der Experten:
Beim Testen mehrerer Angebote erklären Marketingexperten häufig das Angebot mit der höchsten Steigerung zum Gewinner des Tests, obwohl es keinen statistisch signifikanten Unterschied zwischen dem Gewinner und dem Zweitplatzierten gibt.
– Adobe Target Team, Adobe Target Best Practices Guide
Diese Form der « Gewinner-Jagd » ist eine weitere Facette der Gewissheitsfalle und führt zu einer Kette von Fehlentscheidungen, die auf einer reinen Uplift-Illusion basieren.
Einfach oder Komplex: Wann lohnt sich der Aufwand, 5 Variablen gleichzeitig zu testen?
Während A/B-Tests eine Variable (z.B. Überschrift A vs. Überschrift B) vergleichen, erlauben multivariate Tests (MVT) die gleichzeitige Untersuchung mehrerer Variablen und ihrer Kombinationen (z.B. 3 Überschriften, 2 Bilder, 2 CTAs). Dies klingt nach einer enormen Effizienzsteigerung, birgt aber erhebliche statistische Komplexität und Gefahren. Das Hauptproblem ist die « multiple comparison problem » (Problem des multiplen Testens). Jeder einzelne Vergleich innerhalb des Tests erhöht die Wahrscheinlichkeit eines falsch-positiven Ergebnisses. Laut Adobes Testrichtlinien steigt die Falsch-Positiv-Rate bei 5 gleichzeitigen Vergleichen von den üblichen 5 % auf dramatische 18,5 %, wenn keine statistische Korrektur angewendet wird (z.B. die Bonferroni-Korrektur).
Wann lohnt sich also der Mehraufwand? Multivariate Tests sind dann sinnvoll, wenn Sie starke Interaktionseffekte zwischen den Elementen einer Seite vermuten. Beeinflusst eine bestimmte Überschrift die Wirkung eines bestimmten Bildes? Ein MVT kann diese Wechselwirkungen aufdecken, was ein sequenzieller A/B-Test niemals könnte. Der Preis dafür ist jedoch ein drastisch erhöhter Traffic-Bedarf. Da jede mögliche Kombination eine eigene Variante darstellt (3 Überschriften x 2 Bilder x 2 CTAs = 12 Varianten), muss der Traffic auf all diese Gruppen verteilt werden, um für jede einzelne eine ausreichende Stichprobengrösse zu erreichen.
Fallstudie: Multivariate Tests im E-Commerce
Ein E-Commerce-Unternehmen stand vor der Herausforderung, die Produktseite zu optimieren. Anstatt einzelne A/B-Tests für Überschriften, Bilder und Call-to-Actions durchzuführen, entschieden sie sich für einen multivariaten Ansatz. Sie testeten alle Kombinationen gleichzeitig. Wie KlientBoost berichtet, konnten sie so in kürzester Zeit die optimale Kombination identifizieren, die zu einer 23 % höheren Conversion-Rate führte. Sequenzielle A/B-Tests hätten Monate gedauert, um zu einem ähnlichen, aber wahrscheinlich unterlegenen Ergebnis zu kommen.
Die Entscheidung für einen MVT muss strategisch sein: Setzen Sie ihn nur auf Seiten mit sehr hohem Traffic ein und wenn die Hypothese explizit auf der Interaktion von Elementen beruht. Für die meisten anderen Fälle ist ein gut priorisierter, sequenzieller A/B-Test der pragmatischere und statistisch sicherere Weg.
Wie feiern Sie einen Test, der keine Verbesserung brachte, als wichtigen Lernschritt?
In einer von schnellen Erfolgen getriebenen Kultur wird ein A/B-Test ohne signifikanten Uplift oft als Fehlschlag oder Zeitverschwendung angesehen. Das ist ein fundamentaler Denkfehler. Ein Test mit einem « flachen » (inconclusive) oder sogar negativen Ergebnis ist genauso wertvoll wie ein Gewinner – vorausgesetzt, er basierte auf einer klaren Hypothese. Jeder dieser Tests ist eine validierte Lernerfahrung, die Ihr Wissen über Ihre Nutzer erweitert. Ein flaches Ergebnis widerlegt eine Annahme und verhindert, dass Sie Ressourcen in eine falsche Richtung investieren. Es ist eine Schutzmassnahme gegen schlechte Entscheidungen.
Um diese Kultur des Lernens zu etablieren, müssen Sie den Fokus von « Gewinnen » auf « Lernen » verlagern. Feiern Sie nicht den Uplift, sondern die gewonnene Erkenntnis. Die wichtigste Massnahme hierfür ist der Aufbau einer zentralen Lern-Bibliothek (Learning Portfolio). In diesem Wissensspeicher wird jeder durchgeführte Test akribisch dokumentiert: die ursprüngliche Hypothese, die Daten, die sie stützten, das Test-Setup, die finalen Ergebnisse und – am allerwichtigsten – das « Key Learning ». Was haben wir über unsere Nutzer gelernt, das wir vorher nicht wussten? Diese Bibliothek wird zur Goldmine für zukünftige, bessere Hypothesen.
Organisieren Sie regelmässige « Learning Reviews », in denen nicht nur die Gewinner, sondern gezielt auch die « flachen » und negativen Tests vorgestellt und diskutiert werden – ohne Schuldzuweisungen. Machen Sie es zur Regel, dass aus jedem Test mindestens eine neue, verfeinerte Hypothese abgeleitet werden muss. So verwandeln Sie einen vermeintlichen Stillstand in den Startpunkt für die nächste, intelligentere Iteration. Ihre primäre KPI ist nicht mehr nur der Uplift, sondern auch die Test-Geschwindigkeit und die Qualität der generierten Learnings.
Ihre Checkliste für den Audit inconclusiver Tests
- Punkte der Interaktion: Welche Elemente waren im Spiel? Rekapitulieren Sie die genaue Hypothese, das Design der Variante und die definierte Zielmetrik.
- Datensammlung: Analysieren Sie die Ergebnisse der Kontroll- und Variantengruppe sowie relevante Segmentierungsdaten. Gibt es in bestimmten Segmenten (z.B. mobile Nutzer, neuer Traffic) doch einen signifikanten Unterschied?
- Kohärenz-Check: Stand die Hypothese im Einklang mit bekannten qualitativen und quantitativen Nutzerdaten oder war sie eine reine Annahme ohne Fundament?
- Lernpotenzial: Formulieren Sie klar und deutlich, welche Annahme über das Nutzerverhalten durch den Test widerlegt wurde. Was wissen Sie jetzt, was Sie vorher nicht wussten?
- Integrationsplan: Leiten Sie aus diesem Learning mindestens eine neue, verfeinerte Hypothese ab und priorisieren Sie diese für Ihre Test-Roadmap.
Wie identifizieren Sie frustrierte Nutzer, die wütend auf nicht funktionierende Elemente klicken?
Während quantitative Daten aus A/B-Tests das « Was » zeigen, offenbaren qualitative Analysen das « Warum ». Ein besonders aufschlussreiches Phänomen ist der sogenannte « Rage Click ». Ein Rage Click tritt auf, wenn ein Nutzer in kurzer Zeit mehrmals schnell hintereinander auf dasselbe Element klickt. Dies ist ein untrügliches Zeichen für Frustration. Der Nutzer erwartet eine Reaktion – ein Link, ein Pop-up, eine Formularvalidierung –, die aber nicht eintritt. Diese Momente sind Gold wert, denn sie zeigen Ihnen exakt, wo Ihr User Interface die Erwartungen der Nutzer bricht.
Tools wie Hotjar oder Microsoft Clarity können Rage Clicks automatisch identifizieren und Ihnen Heatmaps dieser Frustrationspunkte anzeigen. Die Auswirkungen sind gravierend: Eine Analyse von Amplitude zeigt eine um 75 % niedrigere Conversion-Rate bei Nutzern, die während ihrer Session Rage Clicks ausführen. Diese Nutzer sind nicht nur frustriert, sie brechen mit hoher Wahrscheinlichkeit den Kauf ab. Die Identifikation und Behebung der Ursachen für Rage Clicks ist daher ein extrem wirksamer Hebel zur Steigerung der Conversion-Rate.
Fallstudie: Harrods reduziert Rage Clicks um 50 %
Das Luxuskaufhaus Harrods entdeckte mithilfe von Rage-Click-Maps von Hotjar, dass Nutzer im Checkout-Formular massenhaft auf die Namensfelder klickten. Die Analyse der zugehörigen Session Recordings zeigte die Ursache: Das System akzeptierte keine Sonderzeichen in Namen, was für eine internationale Kundschaft ein erhebliches Problem darstellte. Nach der Behebung dieses technischen Fehlers sanken die Rage Clicks im Checkout von 16 % auf 8 % innerhalb von nur zwei Monaten. Dies führte zu einer signifikanten Verbesserung der Checkout-Abschlussrate und bewies, wie die Beseitigung eines kleinen Frustrationspunktes einen grossen Einfluss auf das Geschäftsergebnis haben kann.
Der Prozess zur Analyse ist systematisch:
- Schritt 1: Identifikation: Nutzen Sie Analytics-Tools, um Bereiche mit wiederholten Klicks (z.B. 3+ Klicks in 2 Sekunden) auf nicht-interaktiven Elementen zu finden.
- Schritt 2: Qualitative Analyse: Schauen Sie sich die Session Recordings der betroffenen Nutzer an. Was hat der Nutzer versucht zu erreichen? Welches Verhalten ging dem Rage Click voraus?
- Schritt 3: Hypothese formulieren: Leiten Sie eine testbare Hypothese ab. Beispiel: « Wenn wir das nicht-klickbare Bildelement, das wie ein Button aussieht, klickbar machen und zur entsprechenden Kategorie verlinken, reduzieren wir die Frustration und erhöhen die Klickrate auf dieser Seite. »
Wie finden Sie heraus, ob « Jetzt kaufen » oder « In den Warenkorb » besser funktioniert?
Die Formulierung Ihres Call-to-Action (CTA) ist einer der am häufigsten getesteten, aber auch am häufigsten missverstandenen Aspekte der CRO. Die Wahl zwischen « Jetzt kaufen » und « In den Warenkorb » ist keine reine Geschmacksfrage, sondern eine strategische Entscheidung, die tief in der Nutzerpsychologie und dem Geschäftsmodell verankert ist. Jede Formulierung erzeugt eine andere mentale Verpflichtung und passt zu einer anderen Phase im Kaufprozess.
« In den Warenkorb » impliziert eine niedrige Verpflichtung. Es ist der digitale Äquivalent zum Hineinlegen eines Produkts in einen Einkaufswagen im Supermarkt. Der Nutzer kann weiter einkaufen, Produkte vergleichen und die Entscheidung später treffen. Diese Formulierung eignet sich hervorragend für klassische E-Commerce-Shops mit einer breiten Produktpalette, in denen das Stöbern und Sammeln von Artikeln ein integraler Bestandteil des Einkaufserlebnisses ist.
« Jetzt kaufen » hingegen erzeugt eine hohe Verpflichtung. Es suggeriert Dringlichkeit und eine finale Entscheidung. Dieser CTA überspringt oft den Warenkorb und führt direkt zum Checkout. Er ist ideal für den Verkauf von Einzelprodukten, Dienstleistungen (wie SaaS-Abos) oder bei zeitlich begrenzten Angeboten, bei denen eine schnelle Entscheidung gefördert werden soll. Die Wahl des falschen CTAs kann zu Reibungsverlusten führen: Ein « Jetzt kaufen »-Button auf einer Seite, auf der Nutzer typischerweise mehrere Artikel kaufen, kann sie vom Weitershoppen abhalten.
Die psychologische Wirkung verschiedener CTAs lässt sich systematisch vergleichen, um eine fundierte Hypothese für Ihren spezifischen Anwendungsfall zu entwickeln.
| CTA-Text | Mentale Verpflichtung | Beste Anwendung | Psychologischer Effekt |
|---|---|---|---|
| In den Warenkorb | Niedrig | Multi-Produkt E-Commerce | Option für später, explorative Phase |
| Jetzt kaufen | Hoch | Einzelprodukte, Dienstleistungen | Dringlichkeit, finale Entscheidung |
| Kostenlos testen | Sehr niedrig | SaaS, Software | Risikofreie Exploration |
| Angebot sichern | Mittel-Hoch | Limitierte Angebote | FOMO, Verlustangst |
Das Wichtigste in Kürze
- Statistische Disziplin ist keine Bremse, sondern die Voraussetzung für valide und profitable Optimierungsentscheidungen.
- Priorisierungs-Frameworks (z.B. PIE, ICE) sind unerlässlich, um Ressourcen auf Tests mit dem höchsten erwarteten Wert zu konzentrieren.
- Ein Test ohne Uplift ist kein Fehlschlag, sondern ein wertvoller Lernprozess, der falsche Annahmen widerlegt und die nächste Hypothese informiert.
Wie steigern Sie die Transaktionsrate von 1% auf 2% und verdoppeln damit effektiv den Gewinn?
Eine Verdopplung der Transaktionsrate von 1 % auf 2 % klingt monumental, ist aber das realistische Ergebnis eines systematischen und disziplinierten CRO-Prozesses. Es geht nicht darum, den einen magischen Test zu finden, der alles verändert. Vielmehr ist es das Ergebnis des Compound-Effekts – der Akkumulation vieler kleiner, aber statistisch valider Verbesserungen über den gesamten Funnel hinweg. Eine 10%ige Verbesserung auf der Homepage, eine 15%ige Steigerung der « Produkt-zu-Warenkorb »-Rate und eine 12%ige Optimierung im Checkout-Start summieren sich nicht einfach, sie multiplizieren sich zu einem erheblichen Gesamtwachstum.
Dieser Prozess ist keine Aneinanderreihung zufälliger Tests, sondern folgt einer klaren Roadmap. Die vier Phasen sind:
- Diagnose: Führen Sie eine umfassende Analyse durch, die quantitative Daten (z.B. Google Analytics) mit qualitativen Einblicken (Heatmaps, Session Recordings, Rage Clicks, Nutzerbefragungen) kombiniert, um die grössten Reibungspunkte im Funnel zu identifizieren.
- Priorisierung: Nutzen Sie ein Framework wie PIE oder ICE, um aus der Fülle an Problemen die Test-Hypothesen mit dem grössten Hebel systematisch zu identifizieren und Ihre Roadmap zu erstellen.
- Iteration: Führen Sie kontinuierliche, statistisch saubere Testzyklen durch. Zielen Sie auf realistische Uplifts pro Funnel-Stufe ab und akzeptieren Sie, dass viele Tests « flach » sein werden – aber wertvolle Learnings liefern.
- Systematisierung: Bauen Sie Ihre Lern-Bibliothek auf. Skalieren Sie gewonnene Erkenntnisse auf andere Bereiche der Website und stellen Sie sicher, dass das gesamte Unternehmen von dem erworbenen Wissen über die Nutzer profitiert.
Der finanzielle Ertrag dieser Vorgehensweise ist enorm. Bei gleichbleibendem Traffic und Marketingbudget führt eine Verdopplung der Conversion-Rate direkt zu einer Verdopplung des Umsatzes. Die 15-jährige Erfahrung von COAX zeigt einen durchschnittlichen ROI von 8:1 für systematische CRO-Programme. Die Investition in statistische Disziplin, Geduld und einen strukturierten Prozess zahlt sich exponentiell aus. Es ist der Übergang von der Hoffnung auf einen Glückstreffer zu einer berechenbaren Wachstumsmaschine.
Fallstudie: Der Zinseszinseffekt kleiner Optimierungen
Ein E-Commerce-Unternehmen mit einem monatlichen Umsatz von 500.000 € implementierte einen disziplinierten CRO-Prozess. Anstatt nach dem einen « Game-Changer » zu suchen, erzielten sie multiple, kleinere Uplifts an verschiedenen Stellen des Funnels: eine 10%ige Steigerung der Klicks von der Homepage auf Kategorieseiten, eine 15%ige Verbesserung der Rate, mit der Produkte in den Warenkorb gelegt wurden, und eine 12%ige Erhöhung der Nutzer, die den Checkout-Prozess starteten. Diese einzelnen Gewinne multiplizierten sich zu einer Gesamtsteigerung der Conversion-Rate von über 40 %. Das Ergebnis waren zusätzliche 200.000 € Umsatz pro Monat – bei exakt gleichem Traffic.
Beginnen Sie noch heute damit, eine Kultur der statistischen Disziplin in Ihrem Team zu etablieren. Analysieren Sie Ihre aktuellen Prozesse und implementieren Sie die hier vorgestellten Frameworks, um Ihre Optimierungsbemühungen von einem Glücksspiel in eine exakte Wissenschaft zu verwandeln.